Q.ANT affianca la luce a una GPU AMD per eseguire un modello linguistico
La NPU Gen 2+ introduce trasformate di Fourier ottiche in un sistema ibrido. Il vantaggio da dimostrare riguarda prestazioni, consumi e qualità del modello completo.
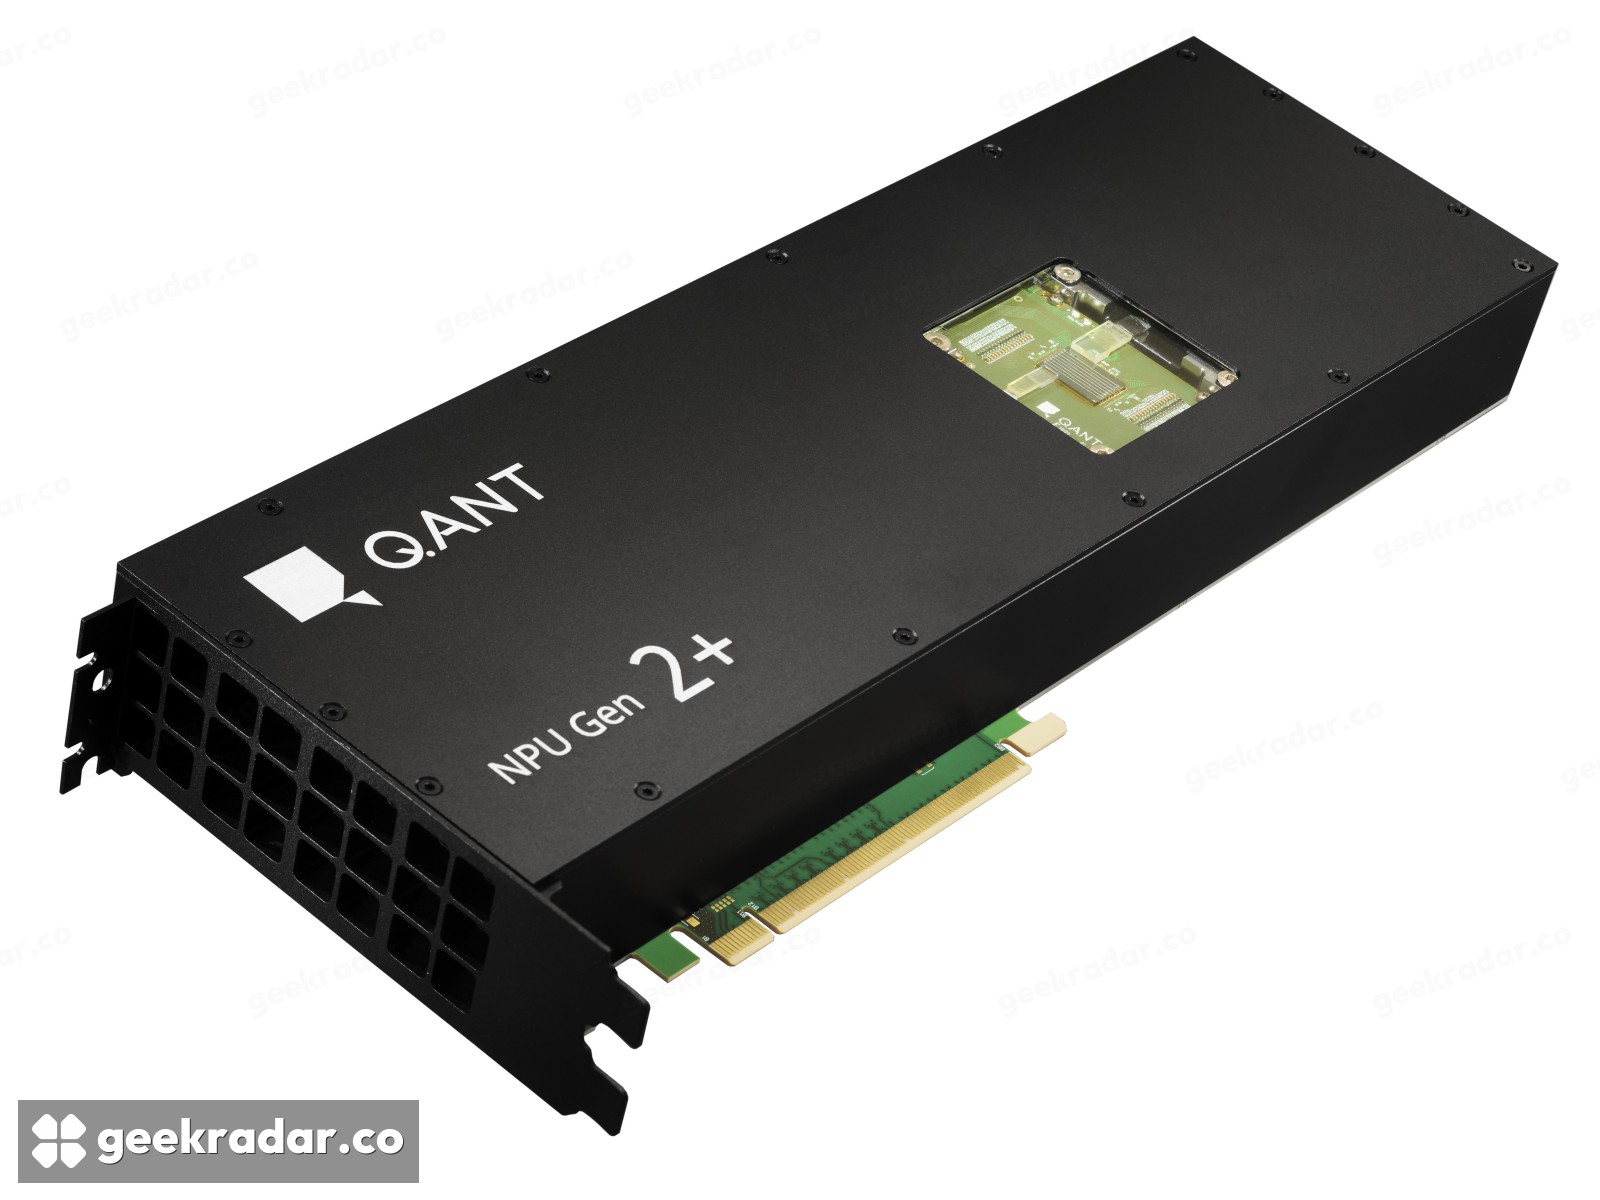
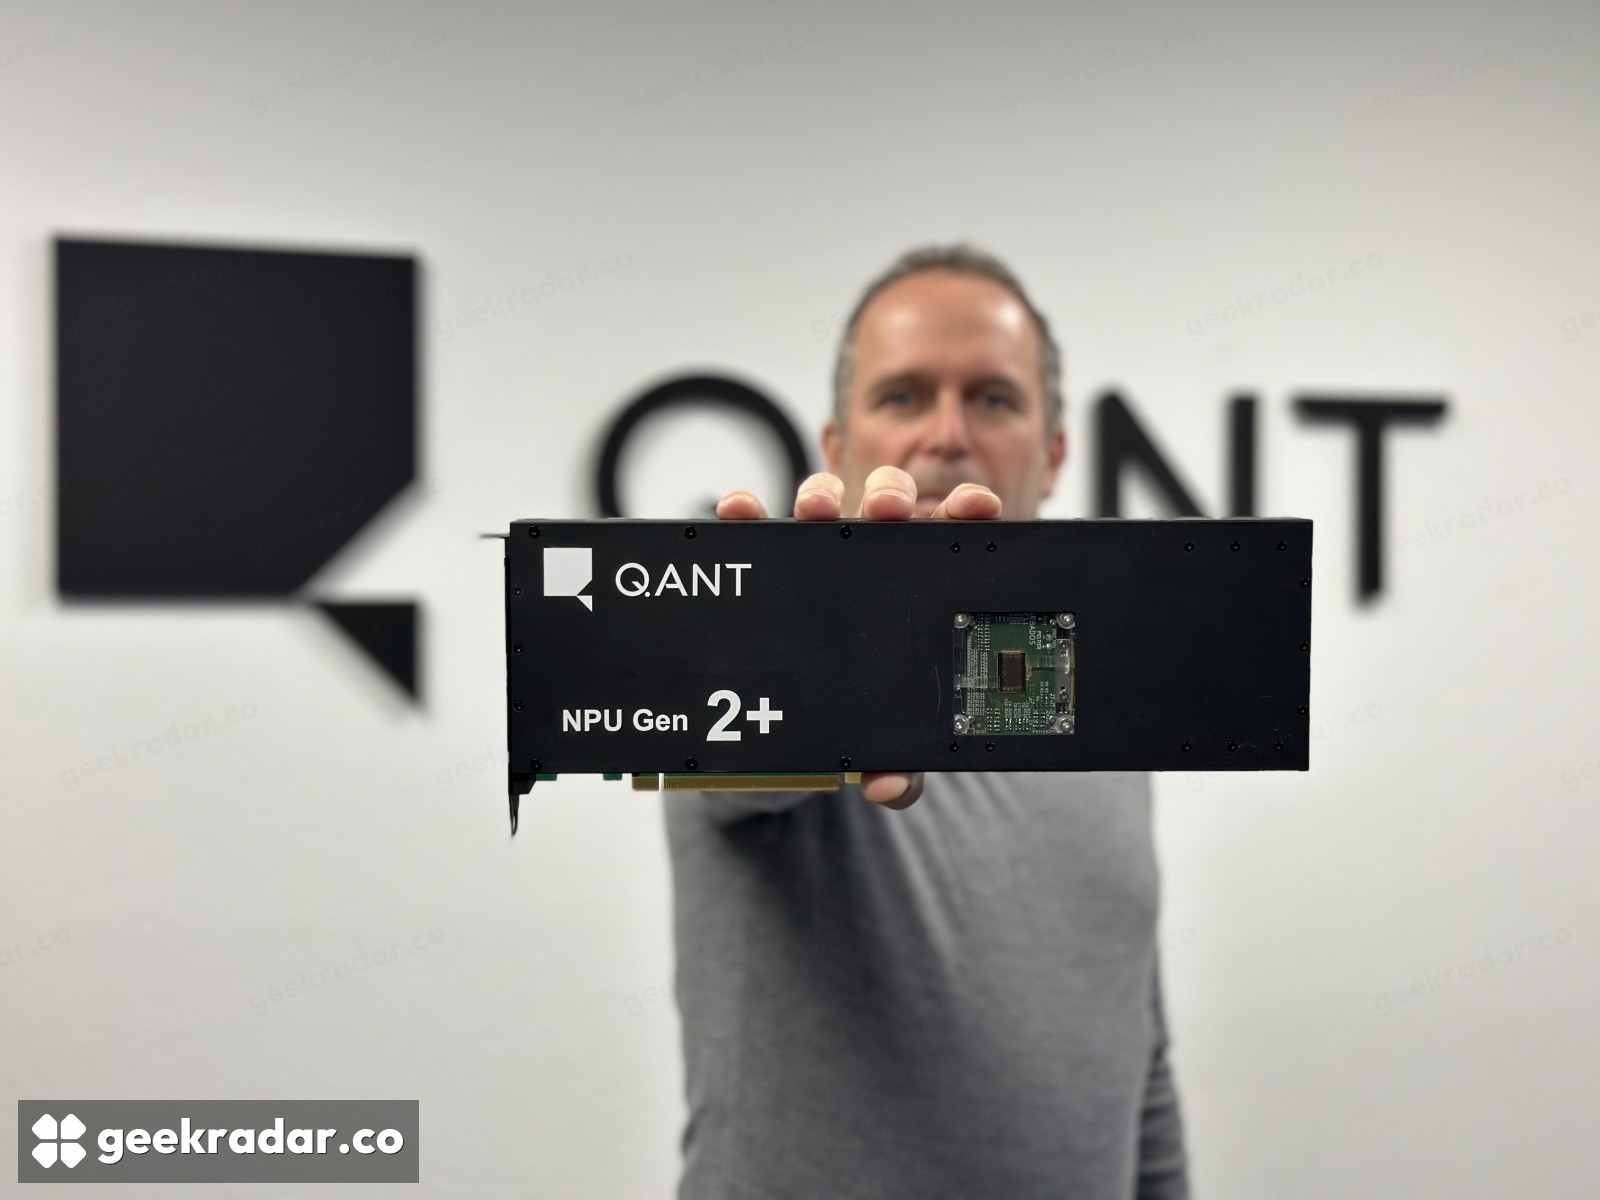
Q.ANT ha mostrato un modello linguistico eseguito insieme da una GPU AMD e da un acceleratore fotonico, che svolge parte dei calcoli usando la luce. La novità interessante è la ripartizione del lavoro: la GPU resta nel sistema, mentre la nuova NPU Gen 2+ mette a disposizione un’operazione matematica ottica attorno alla quale ripensare il modello.
Il processore è stato annunciato il 17 novembre alla conferenza SC26. La sintesi tecnica pubblica di Q.ANT indica una AMD Instinct MI210 e un modello di circa un miliardo di parametri. È quindi una dimostrazione ibrida con componenti identificabili. Da sola, però, non dimostra risposte più rapide o consumi inferiori rispetto a un modello comparabile eseguito con un’architettura convenzionale.
Un acceleratore con un compito diverso
Gen 2+ introduce trasformate discrete di Fourier, o DFT, eseguite direttamente in ottica. Q.ANT spiega di aver usato questa capacità al posto di uno strato di attenzione particolarmente impegnativo dal punto di vista computazionale. Nel suo caso NPU significa Native Processing Unit: la sigla non indica un componente intercambiabile con i processori neurali presenti nei notebook consumer.
Una trasformata di Fourier esprime una sequenza attraverso le sue componenti di frequenza. In un modello linguistico gli ingressi sono rappresentazioni numeriche, non suoni pronunciati: l’operazione offre un modo per mescolare le informazioni contenute in quei valori. La luce, dunque, non serve soltanto a trasportare dati lungo un collegamento, ma partecipa al calcolo.
Questo cambia anche il confronto da fare. Sostituire un componente del modello comporta una scelta sulla sua matematica: non equivale semplicemente a cambiare scheda lasciando identici tutti i calcoli. Un’operazione molto veloce può essere preziosa, purché il modello risultante continui a risolvere bene il problema per cui viene utilizzato.
La precedente ricerca FNet aveva esplorato l’impiego di trasformate di Fourier al posto dell’attenzione negli encoder Transformer, evidenziando un compromesso tra rapidità e accuratezza. È un riferimento utile per capire l’idea, non una convalida dell’hardware Q.ANT o del suo modello generativo. I risultati ottenuti su un benchmark per encoder non diventano il punteggio qualitativo di un altro sistema linguistico.
È la seconda domanda a trasformare una dimostrazione in una scelta concreta. Immaginiamo un servizio in cui la trasformata ottica termina rapidamente, ma il tempo d’attesa dell’utente dipende ancora dal lavoro restante. Accelerare quella trasformata non ridurrebbe automaticamente della stessa misura il tempo necessario per ricevere una risposta. Analogamente, consumare meno per un calcolo non significa abbassare nella medesima proporzione l’assorbimento dell’intero server.
È anche il motivo per cui, nel confronto tra AMD e NVIDIA sul calcolo scientifico, abbiamo distinto una capacità matematica interessante dal lavoro che la circonda. Non occorre sminuire l’acceleratore: occorre valutare il vantaggio nel punto in cui qualcuno lo userà davvero.
Dallo sviluppo software all’accesso all’hardware
Il toolkit open source di Q.ANT distingue già lo sviluppo dall’accesso a una scheda fisica. Il backend su CPU permette di lavorare senza hardware Q.ANT; la variante che usa l’acceleratore richiede invece dispositivi e driver corrispondenti. Q.ANT spiega che sta estendendo il toolkit alle capacità di Gen 2+: la disponibilità del software esistente non equivale quindi al supporto completo del nuovo processore. Una prova simulata riuscita può aiutare a preparare il software, ma non misura prestazioni e consumi della scheda ottica.
Esiste anche una strada verso l’hardware reale. Il programma pilota con IONOS, annunciato il 9 novembre, mette Gen 2, il processore precedente, a disposizione di partecipanti selezionati su server dedicati ospitati in Germania. Servono un caso d’uso concreto e competenze per amministrare autonomamente un server bare metal. È un programma di valutazione limitato, non l’accesso libero alla nuova dimostrazione Gen 2+.
Per chi sviluppa dall’Italia, il dato pratico è quindi l’esistenza di un’infrastruttura europea di sperimentazione, con ammissione su candidatura: non un prodotto acquistabile immediatamente né una garanzia di accettazione. La sede tedesca dei server non cambia la distinzione tra le due generazioni di acceleratore.
Q.ANT prevede sistemi commerciali che combinino Gen 2 e Gen 2+ nella seconda metà del 2027. Restano tre passaggi separati: sperimentare il software, ottenere accesso selezionato all’hardware esistente e adottare in futuro i sistemi con il nuovo processore. Riunirli sotto un unico «disponibile ora» darebbe a un gruppo di sviluppo un’aspettativa sbagliata su ciò che può installare oggi.
Il risultato rende la fotonica interessante come strumento per progettare algoritmi attorno a capacità hardware diverse. Il vantaggio concreto non sta nel sapere che una risposta è passata attraverso la luce: sta nell’ottenere una risposta altrettanto utile usando meno tempo o meno risorse dell’intera macchina. È questo il confronto che dovrà convincere chi paga il server.