AMD e NVIDIA discutono di FP64: conta anche il lavoro fuori dalle matrici
A SC26 AMD difende la doppia precisione nativa, mentre NVIDIA mostra vantaggi dell’emulazione. Carichi e software sono diversi: bisogna confrontare le applicazioni complete.
Al convegno SC26 AMD sostiene che il calcolo scientifico abbia ancora bisogno di hardware potente nella doppia precisione nativa, mentre gli acceleratori per l'IA crescono soprattutto nelle operazioni a precisione ridotta. Il suo nuovo studio sui carichi di lavoro spiega perché l'emulazione FP64 non sia un sostituto universale. I risultati più recenti di NVIDIA con cuBLAS mostrano un'altra possibilità, più circoscritta: alcune applicazioni scientifiche possono guadagnare molto quando i calcoli più costosi si adattano al metodo.
Le due posizioni non sono necessariamente in contraddizione. Conta quanta parte del lavoro può usare l'operazione accelerata, insieme agli effetti sulla memoria, sull'accuratezza e sul resto del programma. Moltiplicare matrici più velocemente è utile; non basta, da solo, a rendere più veloce una simulazione.
La forma del calcolo conta più della sigla
FP64 indica l'aritmetica in virgola mobile a 64 bit, detta doppia precisione, impiegata quando intervallo numerico e precisione sono importanti. Il software scientifico contiene però operazioni differenti: prodotti tra matrici dense, sistemi sparsi, aggiornamenti delle celle vicine in una griglia e combinazioni di risultati parziali. Definirle tutte operazioni FP64 non le rende equivalenti.
Gli schemi Ozaki esaminati ricostruiscono prodotti di matrici ad alta precisione attraverso operazioni a precisione inferiore. Nella spiegazione di cuBLAS pubblicata il 13 novembre, NVIDIA descrive la conversione dei valori in rappresentazioni intere, la moltiplicazione sui Tensor Core e la ricostruzione del risultato. Ozaki-II riduce il numero di moltiplicazioni intere tra matrici rispetto a Ozaki-I.
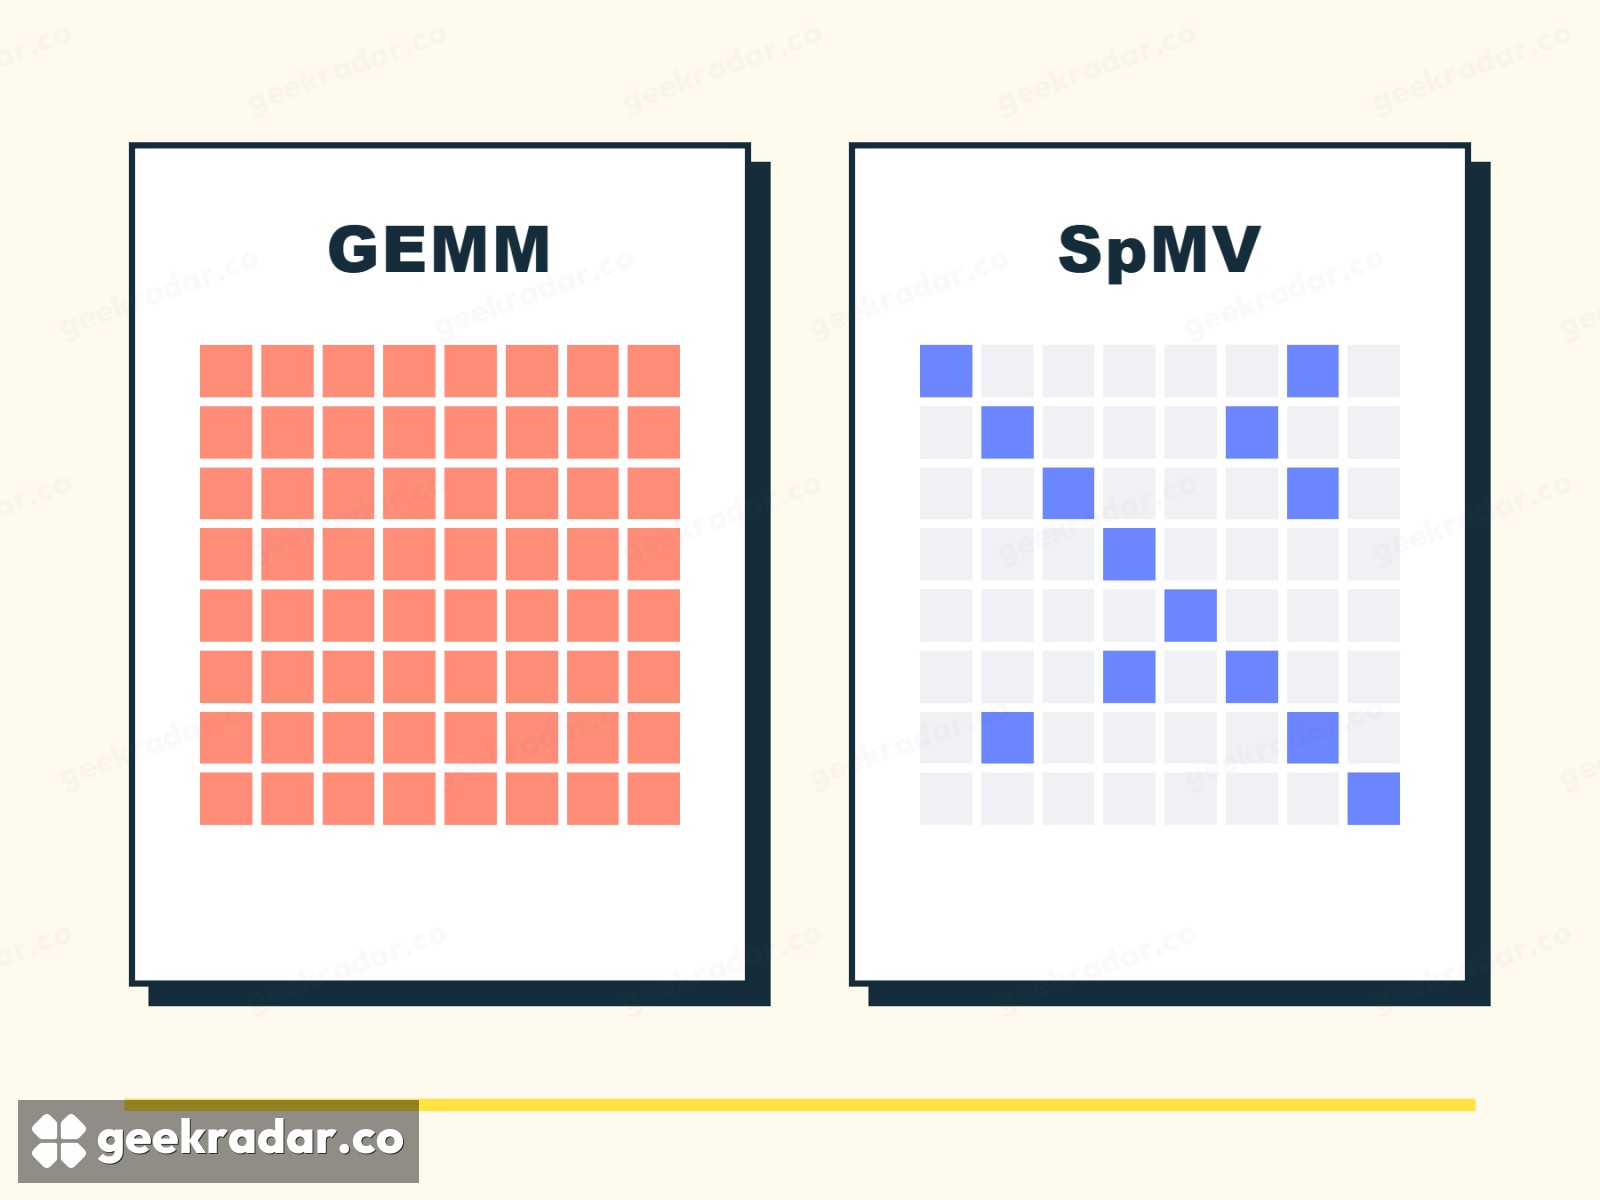
Il bersaglio è GEMM, la moltiplicazione generale di matrici. Una matrice densa si presta all'hardware progettato per elaborare blocchi regolari di numeri. Una simulazione dominata da relazioni sparse o accessi irregolari alla memoria può invece dedicare poco tempo a quel calcolo, anche quando il risultato del singolo GEMM è eccellente.
Lo studio AMD delimita il problema, non censisce il mercato
Il lavoro di ricerca di AMD analizza 47 configurazioni di 11 applicazioni e benchmark, tra cui dinamica molecolare, trasporto di particelle e calcoli su griglie. La tesi è che i grandi prodotti di matrici dense rappresentino una parte limitata di questi carichi. La stima secondo cui l'emulazione sarebbe adatta a meno del 10% dell'ecosistema HPC va letta come conclusione dello studio aziendale, non come un censimento indipendente di tutti i programmi scientifici.
Gli autori chiariscono anche perché un limite imposto dalla memoria non sia una proprietà immutabile del programma. Un'applicazione può attendere soprattutto i dati su un processore e trovarsi invece frenata dal calcolo su un altro, con un diverso equilibrio tra banda e capacità aritmetica. Ridurre l'FP64 nativo può quindi pesare anche se il profilo attuale sembra dominato dagli accessi alla memoria.
C'è un'altra distinzione necessaria. I sistemi provati comprendono una AMD MI355X con ROCm 7.2.1, una NVIDIA B200 con CUDA 13.3.73 e un sistema GB300 con CUDA 13.1. Per le misure dell'emulazione isolata lo studio usa GEMMul8. Implementazione e condizioni software non coincidono con quelle della dimostrazione cuBLAS più recente di NVIDIA. I risultati documentano i metodi e i carichi esaminati, non tutte le possibili esecuzioni delle librerie attuali.
I risultati NVIDIA vanno letti con il loro termine di confronto
NVIDIA dichiara un'accelerazione complessiva di 1,4 volte su GB200 per la sua dimostrazione di chimica quantistica coupled-cluster, usando Ozaki-II con precisione FP64 completa. È un dato più utile del solo picco di un kernel, perché considera l'intero calcolo dimostrato. Rimane però legato a quell'esempio e alla sua base di confronto.
Lo stesso articolo riporta guadagni maggiori con una modalità distinta a precisione mista. Non vanno confusi con il risultato a FP64 completo: cambiare l'impostazione numerica modifica il confronto. NVIDIA descrive inoltre la selezione dinamica della precisione e il ritorno all'FP64 nativo quando l'emulazione non riesce a soddisfare l'accuratezza richiesta entro il limite configurato.
La memoria richiede la stessa attenzione. Il lavoro AMD mostra un consistente spazio aggiuntivo necessario alle configurazioni di emulazione provate. NVIDIA illustra invece una suddivisione in blocchi che limita i dati intermedi in cuBLAS. Attribuire a tutte le implementazioni il massimo consumo osservato in una di esse sarebbe scorretto quanto assegnare a ogni simulazione il vantaggio dell'esempio più favorevole.
Il confronto utile per un centro di ricerca
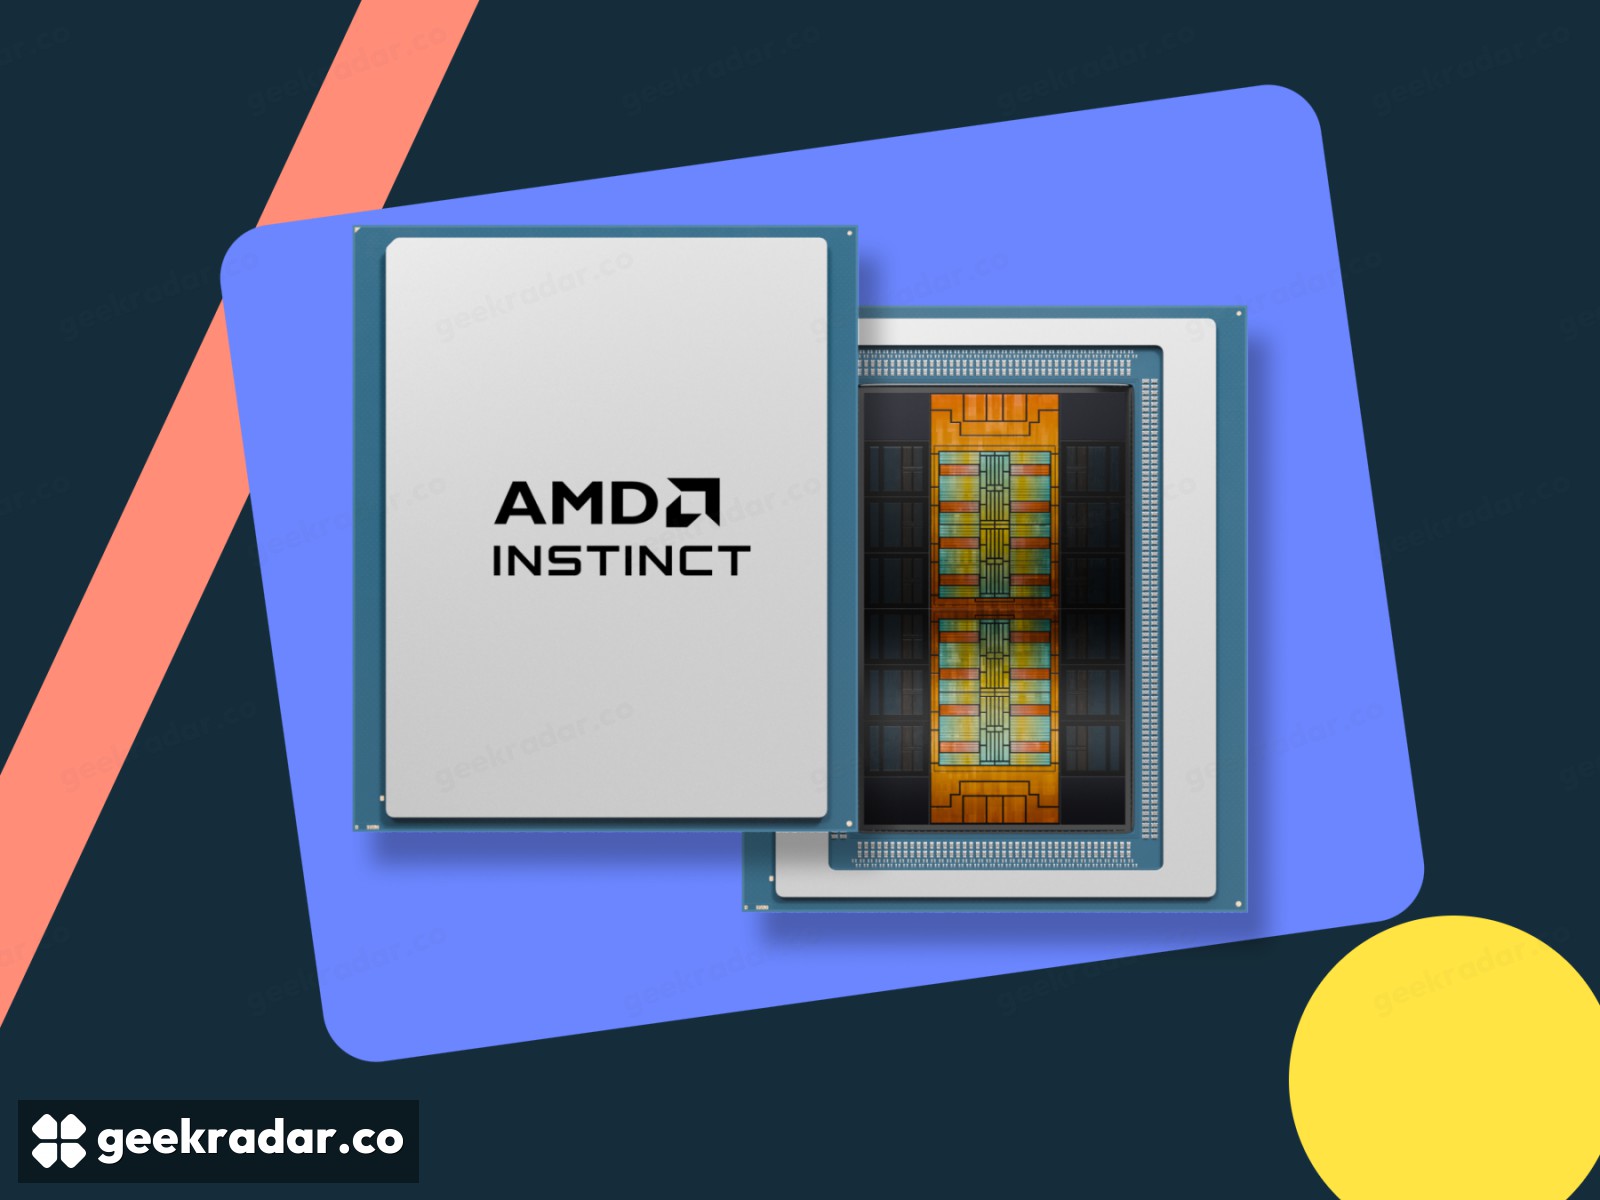
AMD presenta Instinct MI430X con fino a 432 GB di HBM4 e un'enfasi sulla doppia precisione nativa. Nel proprio approfondimento legato a SC26, l'azienda qualifica espressamente i confronti prestazionali MI430X come proiezioni. Non possono essere affiancati a misure applicative come se provenissero dalla stessa sessione di benchmark.
Per un gruppo di ricerca il confronto parte da dati rappresentativi, tolleranze numeriche richieste e una misura di dove viene speso il tempo. Capacità di memoria, comunicazione tra acceleratori e integrazione software possono decidere se il guadagno locale sopravvive nel lavoro completo. Il nostro confronto tra CUDA e ROCm affronta un altro vincolo concreto: le dipendenze che il gruppo deve portare con sé.
Il risultato promettente è che l'hardware orientato all'IA può, in alcuni casi, accelerare il lavoro scientifico esistente mantenendo risultati in doppia precisione. L'errore sarebbe acquistare l'eccezione come se fosse la regola. A un laboratorio serve la macchina che completa prima il suo calcolo validato, comprese le parti che non diventeranno mai un prodotto di matrici.