CUDA contro ROCm: la scelta della GPU parte dalle dipendenze software
Il confronto fra calcolo NVIDIA e AMD passa da applicazioni, hardware supportato e lavoro di conversione. Portare il sorgente non garantisce compatibilità binaria o pari velocità.
CUDA contro ROCm significa scegliere il software capace di utilizzare una GPU e il lavoro necessario per mantenerlo funzionante. La piattaforma CUDA di NVIDIA e l'ecosistema ROCm di AMD supportano entrambi il calcolo accelerato. Il loro valore dipende da librerie, framework, hardware compatibile e requisiti di distribuzione, ben prima che diventi utile un dato teorico di potenza.
Per chi utilizza un'applicazione esistente, la scelta potrebbe essere già stata fatta dagli sviluppatori. Per chi scrive software GPU, comprende anche un impegno più lungo verso strumenti e portabilità. I due gruppi non dovrebbero ricevere lo stesso consiglio d'acquisto.
Il vantaggio CUDA parte da una dipendenza concreta
NVIDIA descrive CUDA come una piattaforma di calcolo accelerato comprendente toolkit, librerie e strumenti di sviluppo, accessibile attraverso linguaggi e framework. Molti utenti non scrivono mai direttamente un kernel GPU: dipendono da un pacchetto o da un'applicazione che ha già scelto come utilizzare l'acceleratore.
Se un programma indispensabile supporta soltanto CUDA per l'accelerazione, hardware NVIDIA compatibile rappresenta il percorso diretto. È un requisito software, non la prova che ogni GPU NVIDIA sia più veloce di qualsiasi alternativa AMD. Il programma potrebbe funzionare anche sulla CPU, ma comprare una GPU che non può utilizzare vanificherebbe il motivo dell'acquisto.
Il compromesso è la concentrazione delle dipendenze. Un progetto costruito attorno a librerie o comportamenti specifici NVIDIA può richiedere lavoro significativo prima di usare un altro sistema di accelerazione. Quel costo può essere giustificato dalle funzioni ottenute. Va comunque riconosciuto come dipendenza tecnica, senza nasconderlo dietro una promessa generica di portabilità futura.
ROCm identifica configurazioni supportate
La matrice di compatibilità ROCm elenca combinazioni hardware e sistemi operativi, sottolineando l'allineamento fra firmware, driver e componenti in spazio utente. Bisogna verificare la GPU precisa e l'ambiente software. Il marchio Radeon, una memoria sufficiente o l'installazione riuscita dei driver da gioco non rispondono a questa domanda.
ROCm merita attenzione quando framework e operazioni necessari supportano il relativo sistema di accelerazione sull'hardware effettivamente utilizzabile. Offre un percorso AMD, interessante per diversificare gli acquisti o sfruttare macchine già presenti. Una dichiarazione generale di supporto del framework può però non comprendere ogni estensione, operazione personalizzata o versione dei pacchetti del progetto.
Un modello, per esempio, può caricarsi correttamente mentre un'implementazione opzionale dell'attenzione o un'estensione esterna continua a presupporre CUDA. La verifica utile comprende tutto il lavoro: preparazione dei dati, esecuzione, controllo dei risultati ed eventuale esportazione o servizio di inferenza. Un notebook introduttivo completato dimostra molto meno.
HIP riduce il lavoro di conversione, senza eliminarlo
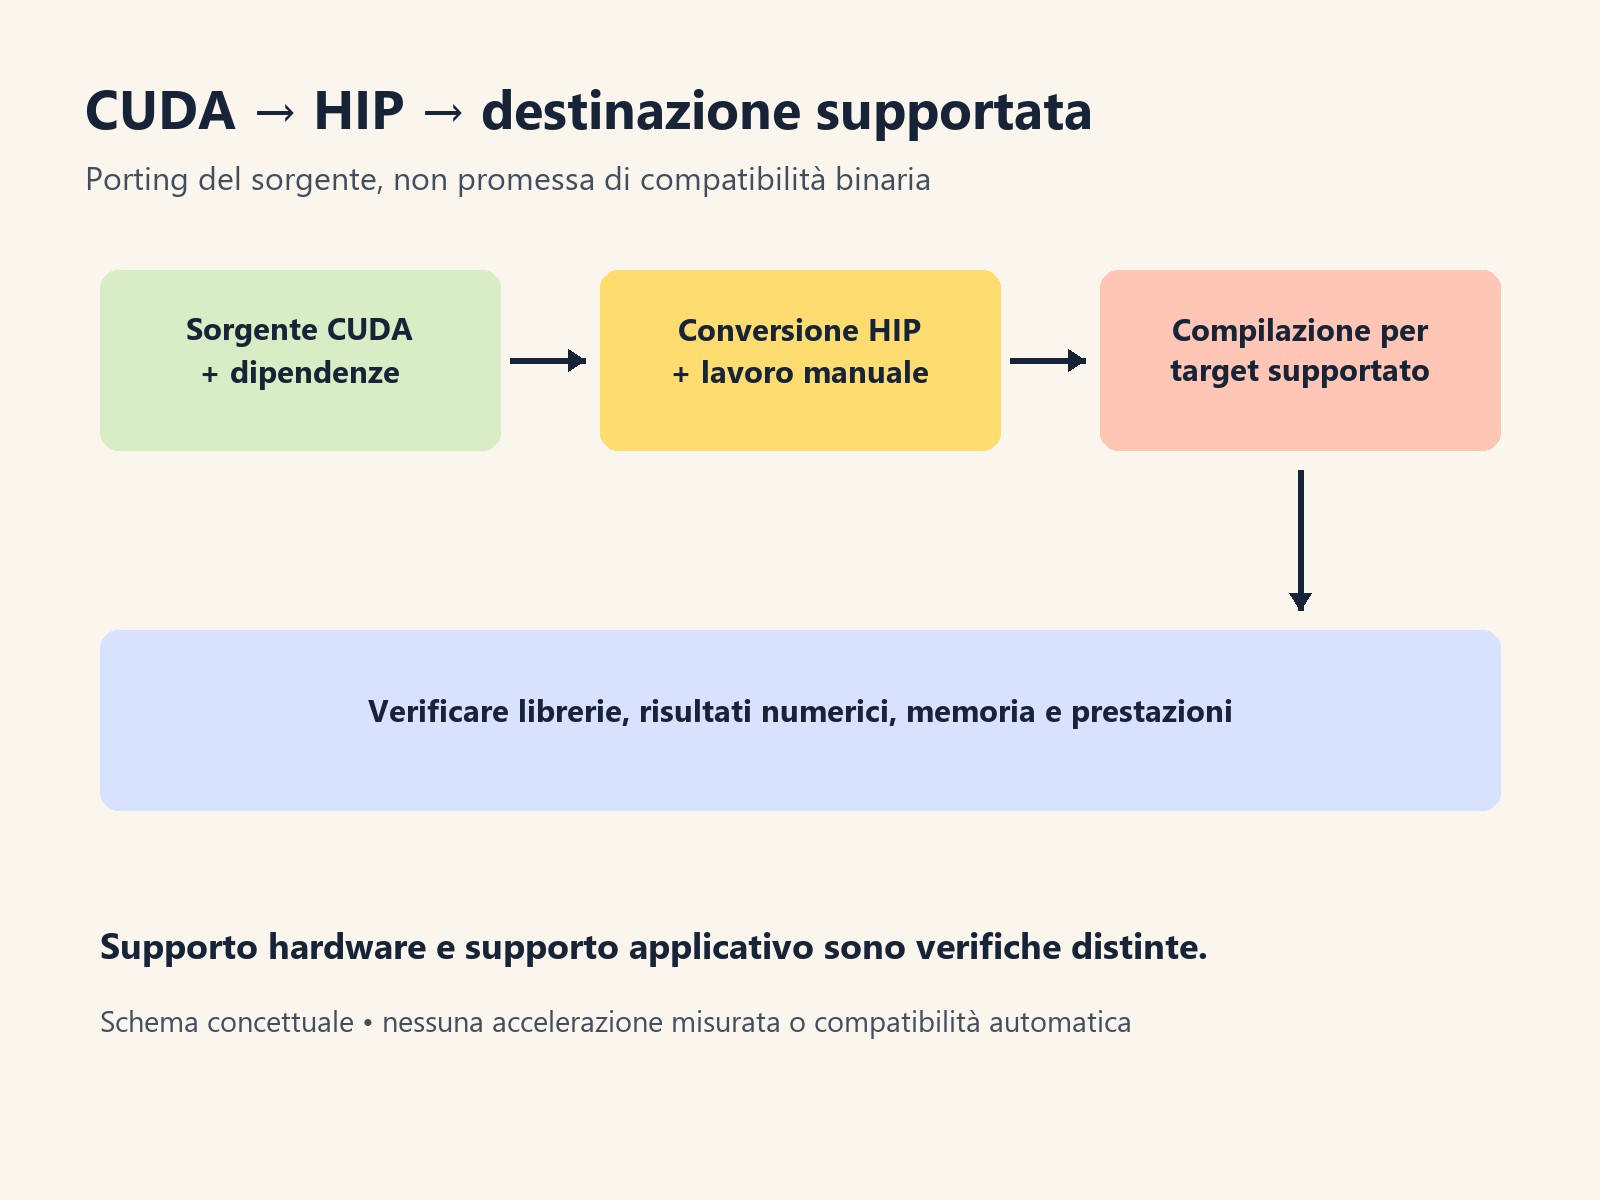
Le domande frequenti AMD su HIP spiegano che HIPIFY può convertire parti consistenti del codice runtime CUDA, mentre capacità non supportate e dettagli dell'architettura possono richiedere ulteriori interventi. È una migrazione del codice sorgente. Non significa poter avviare su Radeon un qualsiasi programma CUDA già compilato.
La conversione ha inoltre due traguardi. Prima viene l'esecuzione corretta, poi una prestazione utile. Accessi alla memoria, librerie e configurazione dei kernel possono richiedere ottimizzazioni differenti. Occorre prevedere validazione e manutenzione anche dopo la prima compilazione riuscita, soprattutto se entrambi i percorsi dovranno restare supportati durante l'evoluzione del programma.
| Situazione iniziale | Caso favorevole a CUDA | Caso favorevole a ROCm |
|---|---|---|
| Applicazione solo CUDA | Percorso diretto su hardware NVIDIA compatibile | Serve un'alternativa reale o una conversione |
| Framework con entrambi i sistemi | Verifica di pacchetto CUDA ed estensioni | Verifica di pacchetto ROCm, hardware esatto e operazioni |
| Sviluppo GPU personalizzato | Accesso diretto agli strumenti e alle librerie NVIDIA | Distribuzione su AMD, con HIP come possibile strumento di portabilità |
| Costo nel tempo | Dipendenze specifiche NVIDIA | Validazione, eventuale migrazione e ottimizzazione |
La precedente analisi su Hopper affrontava le prestazioni come un problema di sistema. Lo stesso criterio serve qui: l'acceleratore è un componente dell'ambiente di calcolo, non l'ambiente completo.
Misura il lavoro completato
Un confronto utile mantiene costanti attività, qualità del risultato, precisione e requisiti di memoria. Nell'inferenza vanno specificate le condizioni di throughput e latenza; nell'addestramento contano comportamento numerico e tempo per raggiungere il risultato previsto. Più memoria può rendere possibile un lavoro altrimenti troppo grande, senza dimostrare maggiore velocità quando entrambe le schede hanno capacità sufficiente.
Scegli CUDA quando il percorso software supportato porta il lavoro necessario in produzione con il minor impegno giustificato. Scegli ROCm quando l'intera applicazione funziona su una configurazione AMD supportata e costi, capacità o flessibilità degli acquisti compensano la manutenzione. L'acquisto decisivo completa il lavoro in modo affidabile: la potenza teorica irraggiungibile dal software rimane sulla scheda tecnica.


