Nvidia Nemotron 3.5 Transcribe lascia scegliere come trascrivere l’audio
Pesi scaricabili, voci distinte e riferimenti temporali ampliano gli usi. Il runtime più veloce dichiarato non è ancora nella versione aperta.
Nemotron 3.5 Transcribe di Nvidia riceve una registrazione e un’istruzione su come trasformarla in testo: mantenere esitazioni, rendere la lettura più scorrevole, riconoscere termini specialistici o distinguere le voci. La novità interessante è che lo stile della trascrizione entra nel compito, invece di essere soltanto una revisione successiva.
La versione pubblicata il 28 ottobre mette a disposizione pesi scaricabili per elaborare registrazioni fino a un’ora in 40 lingue. «Offline» indica il trattamento di file, non un riconoscitore in streaming dal vivo. Non significa che il modello completo possa funzionare agevolmente su qualsiasi portatile.
Una trascrizione può servire scopi diversi
Un’intervista ricercabile, i sottotitoli e un documento per ricerca linguistica richiedono scelte differenti. Eliminare ripetizioni migliora talvolta la leggibilità, ma può cancellare informazioni sul modo di parlare. Le etichette delle voci rendono consultabile una riunione senza identificare automaticamente le persone reali.
Le istruzioni consentono di specificare queste differenze. Un contesto facoltativo può fornire il vocabolario di una discussione tecnica: utile quando il nome di un prodotto assomiglia a una parola comune, senza diventare una prova che il modello lo abbia effettivamente sentito.
La scheda tecnica del modello distingue trascrizione, traduzione, attribuzione delle voci e comprensione dell’audio. L’italiano compare nella matrice per trascrizione, traduzione da e verso l’inglese, più interlocutori e passaggi fra lingue. È un motivo concreto d’interesse per chi lavora con registrazioni italiane. La stessa scheda precisa però che comprensione e ragionamento sull’audio sono stati valutati soltanto in inglese: non tutte le funzioni hanno identica copertura.
La velocità dichiarata dipende da un ambiente preciso
Nvidia dichiara fino a 2.238 secondi di audio elaborati al secondo su una RTX PRO 6000 Blackwell Server Edition, con implementazione NIM ottimizzata, precisione NVFP4 e decodifica speculativa. È una misura di capacità complessiva in una configurazione specifica, non il tempo garantito a chiunque scarichi i pesi.
La scheda aggiunge una precisazione sostanziale: quelle ottimizzazioni non sono ancora nella distribuzione open source. Nvidia prevede che l’integrazione NeMo Speech disponibile al lancio sia circa due volte più lenta. Anche la guida iniziale per FP8 usa una scheda professionale da 96GB. Rendere scaricabile un modello facilita l’accesso, senza eliminare i requisiti hardware e il lavoro di configurazione.
La precisione introduce un altro compromesso. Esistono versioni BF16, FP8 e NVFP4, ma la tabella dei benchmark nella scheda FP8 riporta risultati BF16. Nvidia indica separatamente per FP8 un errore medio di trascrizione superiore dell’1% in termini relativi. Non è un aumento di un punto percentuale e non va confuso con il punteggio del modello BF16.
Il controllo serve se il risultato resta verificabile
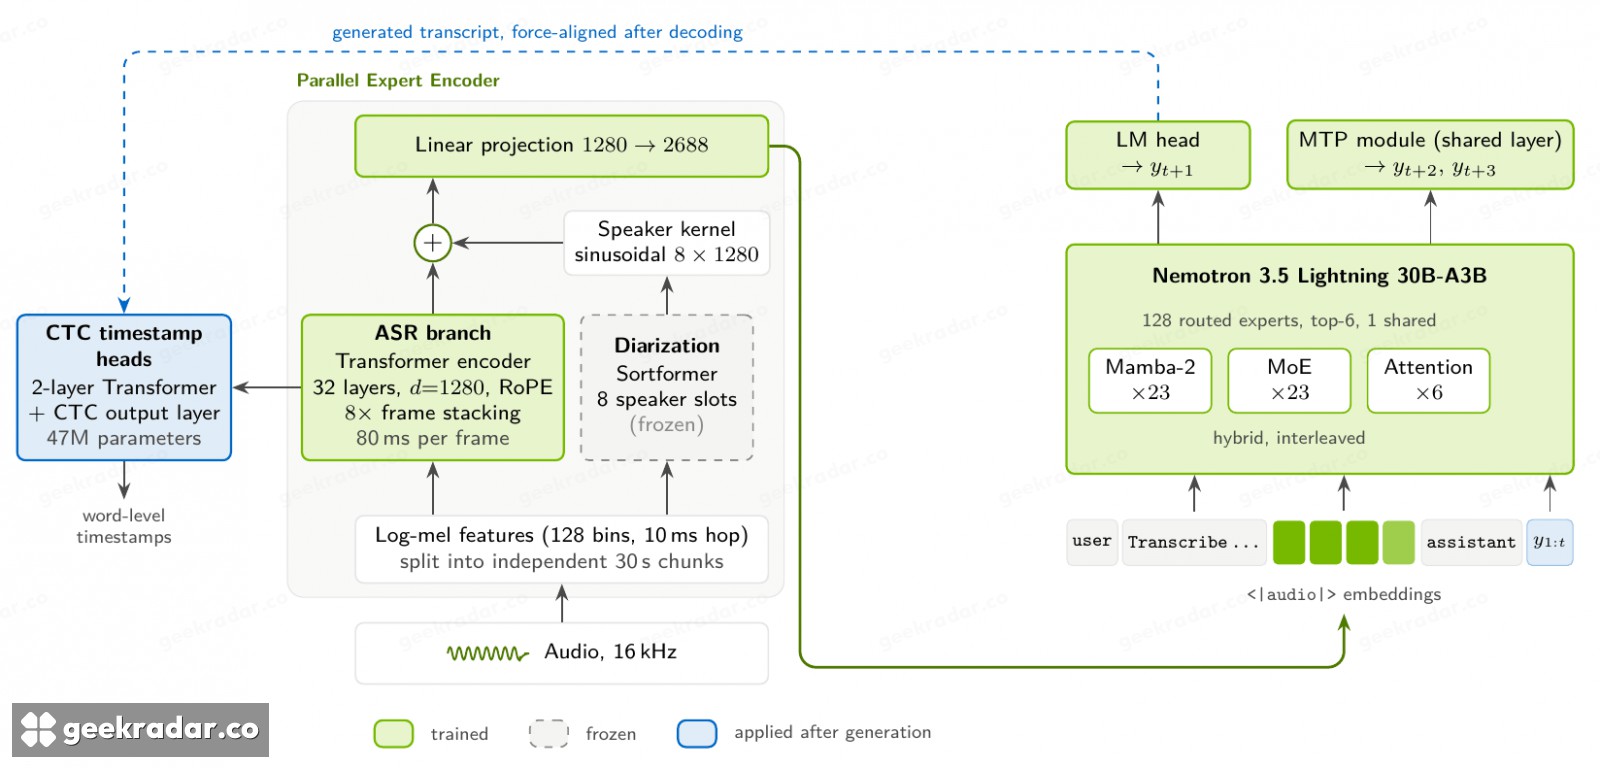
Riferimenti temporali alle parole e testo suddiviso per interlocutore possono semplificare il controllo di una registrazione lunga. Il revisore torna al passaggio pertinente invece di cercarlo in un’ora di audio. È un vantaggio pratico più concreto dell’idea che un buon piazzamento valga per ogni accento, microfono o conversazione specialistica.
I pesi sono distribuiti con licenza OpenMDW 1.1; condizioni e avvisi dei componenti sono collegati nella scheda. Resta necessario scegliere l’ambiente adatto, gestire i permessi per trattare le registrazioni e verificare la funzione nella lingua effettivamente utilizzata.
L’aspetto più promettente è quindi l’accordo esplicito fra istruzione e trascrizione. Sapere se un’esitazione debba restare oppure essere eliminata permette di servire lavori diversi. La registrazione rimane il riferimento quando una frase ben rifinita suona più sicura di chi l’ha pronunciata.


