Il tokenizer di BERT accelera, ma l’intera applicazione non diventa 50 volte più veloce
L’ottimizzazione Unicode di Hugging Face riporta l’attenzione alla preparazione del testo. Il vantaggio dipende dalla versione confrontata e dal carico reale.
Hugging Face ha descritto un forte aumento della velocità di preparazione del testo per i modelli della famiglia BERT, riducendo il lavoro Unicode non necessario. Il dato principale è notevole: fino a circa 50 volte la velocità di codifica rispetto alla vecchia versione tokenizers 0.23. È però facile interpretarlo male: il risultato riguarda il tokenizer, non un'intera applicazione di intelligenza artificiale 50 volte più veloce.
Nel resoconto tecnico del 15 ottobre, Simon Brandeis descrive un intervento ancora nella fase di proposta di modifica al codice al momento della pubblicazione. Il repository per riprodurre le misurazioni identifica le revisioni confrontate e fornisce gli strumenti di benchmark. Si tratta dunque di una misura degli sviluppatori con materiale verificabile, non di un test indipendente di GeekRadar.
Il modello non elabora direttamente il testo originale
Un tokenizer trasforma il testo negli identificatori utilizzati dal modello. Prima di selezionare i token può normalizzare i caratteri, trattando maiuscole, accenti o rappresentazioni Unicode equivalenti secondo regole specifiche. La documentazione dei componenti distingue normalizzazione, pre-tokenizzazione e selezione dei token propria del modello.
Questa separazione spiega perché una parte apparentemente poco innovativa del processo continui a contare. Un servizio può usare un modello compatto per cercare documenti, classificare testo o ordinare risultati. Se il modello è già rapido, il lavoro della CPU necessario a preparare ogni ingresso può occupare una quota significativa del tempo totale. Un acceleratore più veloce non eliminerebbe necessariamente quel collo di bottiglia.
L'ottimizzazione descritta da Brandeis evita procedure generali costose quando il testo consente un percorso equivalente più economico, anche nel caso comune dei caratteri ASCII. Il vincolo essenziale è l'equivalenza: la velocità serve solo se il tokenizer produce ancora gli identificatori attesi dal modello. Cambiare la normalizzazione può alterare l'ingresso del modello anche quando il testo visibile sembra identico a chi legge.
Un componente rapido non accelera tutto nella stessa misura
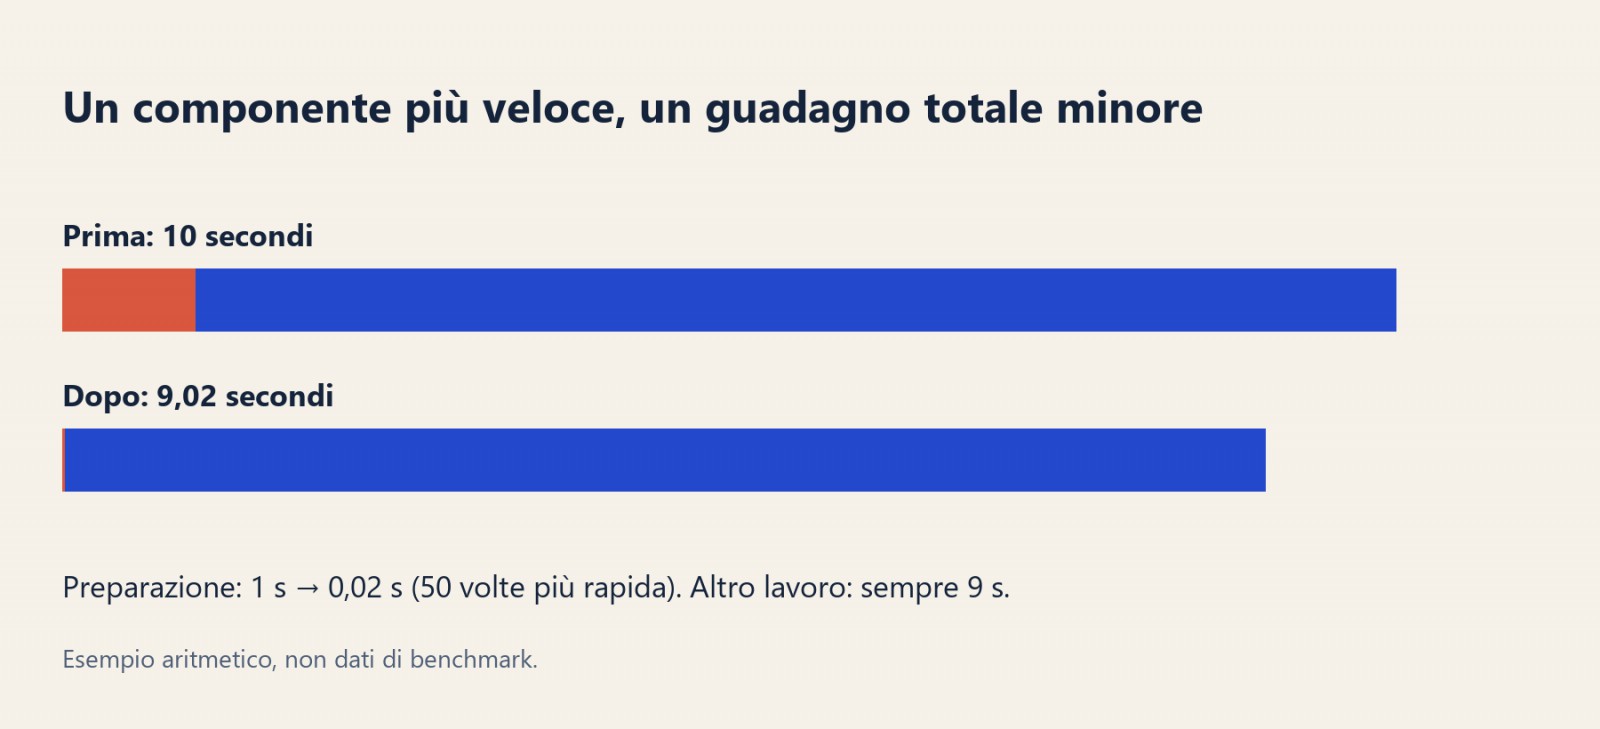
Immaginiamo, come semplice esempio, che la preparazione richieda un secondo e tutto il resto nove. Anche eliminando completamente la preparazione rimarrebbero nove secondi di lavoro. Il guadagno complessivo sarebbe contenuto, nonostante un'accelerazione illimitata del componente isolato. Un carico dominato dalla preparazione avrebbe invece molto di più da guadagnare.
Per questo un moltiplicatore richiede sempre una base di confronto e un carico definiti. Il confronto con la versione 0.23 comprende miglioramenti precedenti oltre alla nuova ottimizzazione. Non va presentato come il beneficio di una singola piccola patch rispetto all'ultima versione di sviluppo. Allo stesso modo, un risultato ottenuto su un tipo di testo non diventa una promessa per ogni lingua o lunghezza dell'ingresso.
La metodologia pubblicata usa misurazioni su un solo thread, su sistemi AMD EPYC e Intel Xeon, alternando le esecuzioni e controllando i risultati prodotti. Il repository rende il confronto più ispezionabile: permette di identificare le modifiche e il codice che ha generato una misura. È una base più solida di un grafico privo delle versioni software, anche se riprodurre la configurazione dell'autore resta diverso dal misurare la propria applicazione.
Anche i modelli meno recenti meritano ottimizzazioni
Gli encoder della famiglia BERT continuano a servire compiti che non richiedono a un modello conversazionale di generare una risposta. Un sistema di ricerca può ordinare risultati o rappresentare testi numericamente senza produrre una lunga risposta. Migliorare il software circostante può quindi rendere più utile un'architettura esistente senza modificarne i pesi appresi.
L'unità di confronto dipende dal lavoro: latenza per un'applicazione interattiva, quantità di documenti elaborati nel tempo per un processo continuativo, memoria e costo operativo per un sistema con risorse limitate.
Il risultato invita a misurare l'intero percorso, dal testo ricevuto alla risposta restituita. Se domina la normalizzazione, l'ottimizzazione merita una prova quando sarà disponibile nella versione adottata. Se dominano inferenza o recupero dei dati, il grande moltiplicatore del tokenizer potrebbe cambiare ben poco il tempo percepito dall'utente.