Google TPU 8tx e 8i Max affrontano due problemi diversi: riservatezza e attesa dei dati
Le configurazioni abbinano silicio esistente a scelte di sistema diverse. Confidential computing e banda della memoria rispondono a vincoli distinti.
La gamma TPU ampliata da Google affronta due ostacoli distinti nell’esecuzione di grandi carichi di IA: proteggere le informazioni sensibili mentre vengono elaborate e alimentare i processori con abbastanza dati. TPU 8tx si concentra sul primo, TPU 8i Max sul secondo. È una distinzione più utile che considerarli due gradini di una sola classifica di acceleratori.
Nell’annuncio del 9 novembre, Google presenta nuove configurazioni di sistema costruite intorno al silicio già appartenente all’ottava generazione. Conta perché memoria, processori host e collegamenti influenzano il comportamento dell’insieme quanto le operazioni eseguite dal singolo chip.
TPU 8tx protegge i dati durante l’elaborazione
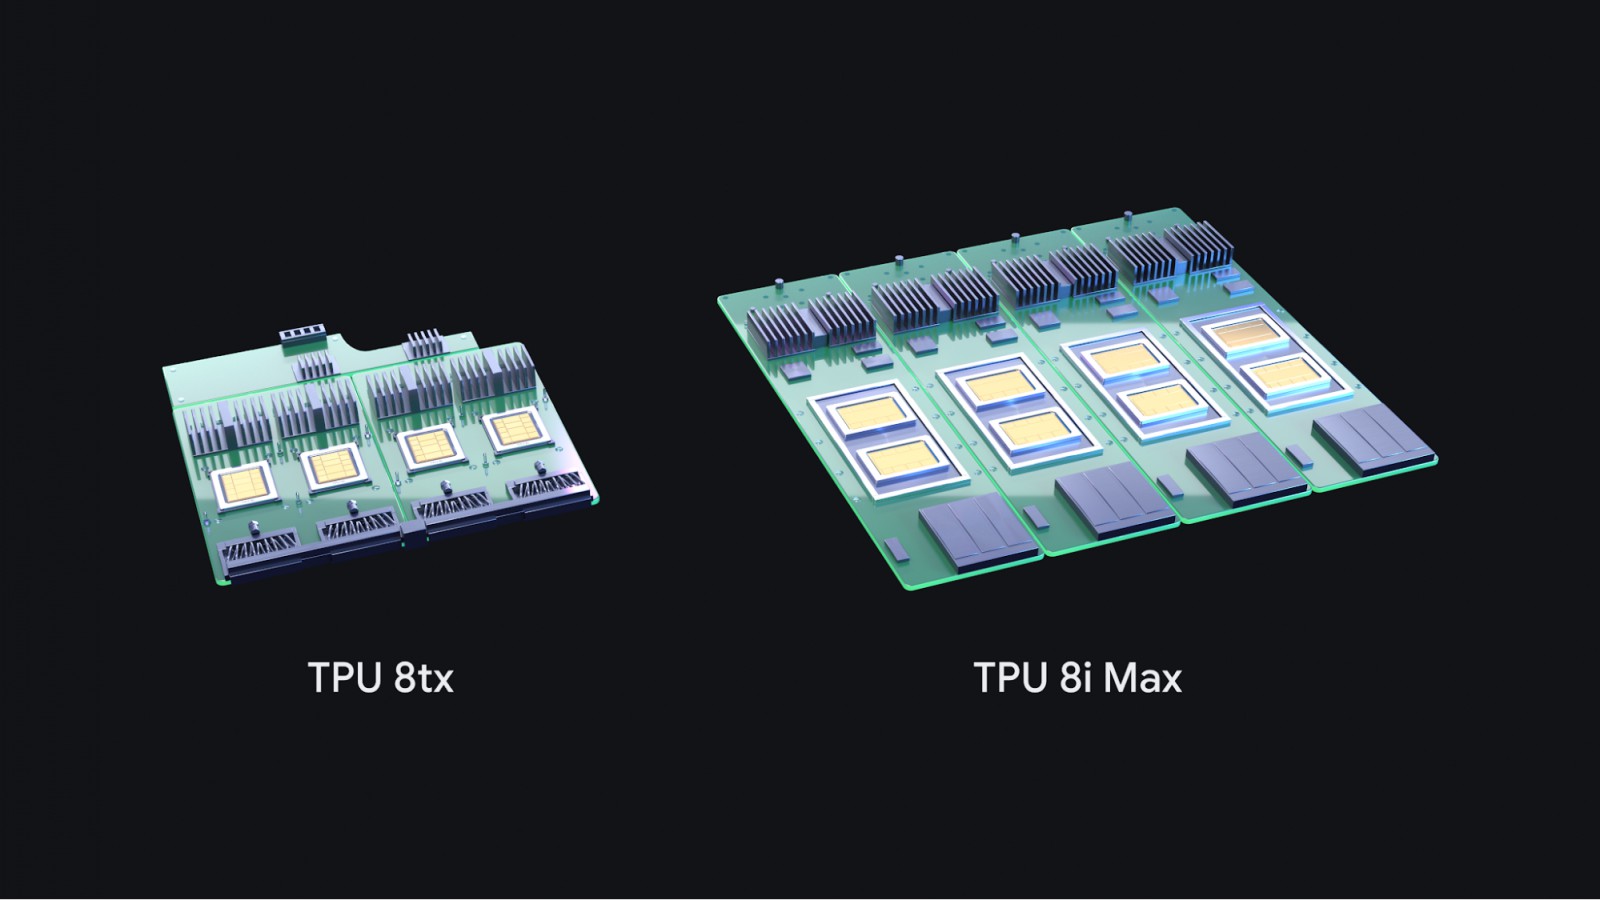
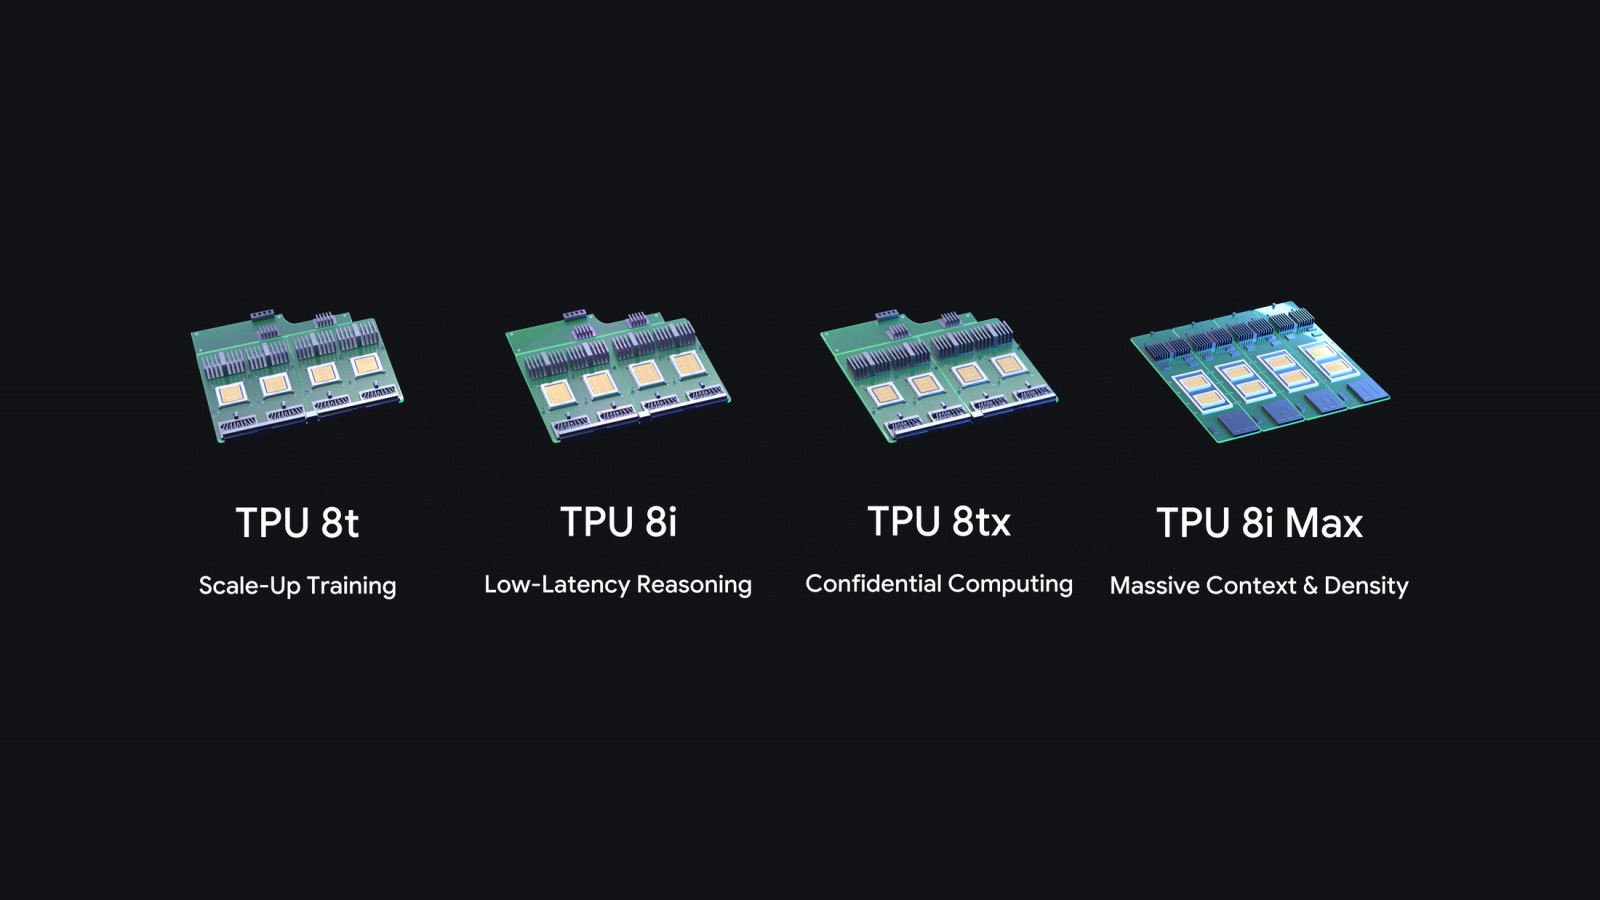
TPU 8tx abbina il silicio di TPU 8t a host AMD EPYC di quinta generazione e alla rete Boardfly a bassa latenza. Google lo propone per inferenza riservata e addestramento su scala ridotta, compreso l’adattamento di modelli con informazioni private. L’azienda dichiara una latenza fino a due volte inferiore rispetto a TPU 8t e un impatto prestazionale quasi nullo dell’approccio di sicurezza: sono dichiarazioni del produttore, non misure indipendenti di GeekRadar.
Il problema di sicurezza è specifico. Cifrare un file conservato su disco o un collegamento di rete non protegge automaticamente i dati durante il calcolo. La panoramica Google sul confidential computing descrive isolamento e protezione dei dati in uso basati sull’hardware, con strumenti di attestazione per verificare gli ambienti fidati.
Questo non rende irrilevanti i permessi dell’applicazione. Un calcolo protetto può comunque restituire un risultato a un chiamante autorizzato, e il software può concedere a quel chiamante più informazioni del necessario. Isolamento hardware e regole di accesso affrontano parti differenti del problema. Chi sceglie questa soluzione deve definire quali dati vuole nascondere, a chi e in quale passaggio del lavoro.
TPU 8i Max cerca di tenere occupato il calcolo
TPU 8i Max unisce due chip TPU 8i in un unico package. Secondo Google, rispetto a TPU 8i raddoppiano capacità di calcolo, SRAM e banda della memoria ad alta velocità. È un confronto tra risorse del sistema, non la garanzia che ogni applicazione diventi due volte più rapida.
Si pensi a un carico nel quale il processore aspetta frequentemente i dati. Aggiungere capacità aritmetica può lasciare intatta quell’attesa. Aumentare la banda della memoria insieme al calcolo serve a mantenere il rapporto tra lavoro eseguito e informazioni necessarie per eseguirlo. I contesti lunghi rendono particolarmente importante questo equilibrio, perché una quantità maggiore di informazioni deve restare accessibile mentre il modello continua a produrre risultati.
L’annuncio non offre un prezzo universale per il cliente o un risultato trasferibile senza modifiche a qualunque modello. Un confronto utile mantiene costanti modello, precisione, lunghezza del contesto, richieste simultanee e obiettivo di latenza. Guardare solo il throughput massimo può premiare una configurazione che non rispetta i tempi di risposta necessari a un servizio interattivo.
Il software decide quanto è praticabile la scelta
Google richiama anche il proprio lavoro su PyTorch, dopo il supporto nativo alle TPU già esaminato. L’accessibilità conta: un acceleratore adatto sulla carta offre poco valore se adottarlo comporta una riscrittura troppo costosa o operazioni non supportate dal modello usato.
Per un’organizzazione italiana, prezzi contrattuali e disponibilità nella regione scelta restano verifiche separate: l’annuncio dei sistemi non dimostra da solo che ogni configurazione sia ordinabile in qualsiasi sede europea. Le ragioni per approfondire rimangono due: il confine di protezione dell’esecuzione per i dati sensibili e l’organizzazione della memoria per i contesti estesi. La scelta utile parte dal vincolo che oggi impedisce all’applicazione di lavorare bene, prima che dal numero più grande in una presentazione.