LiquidCodec rende i token vocali più prevedibili, oltre che più rapidi da decodificare
Liquid AI spiega il codec da 74 milioni di parametri e il significato delle misure di velocità e qualità nei sistemi vocali locali.
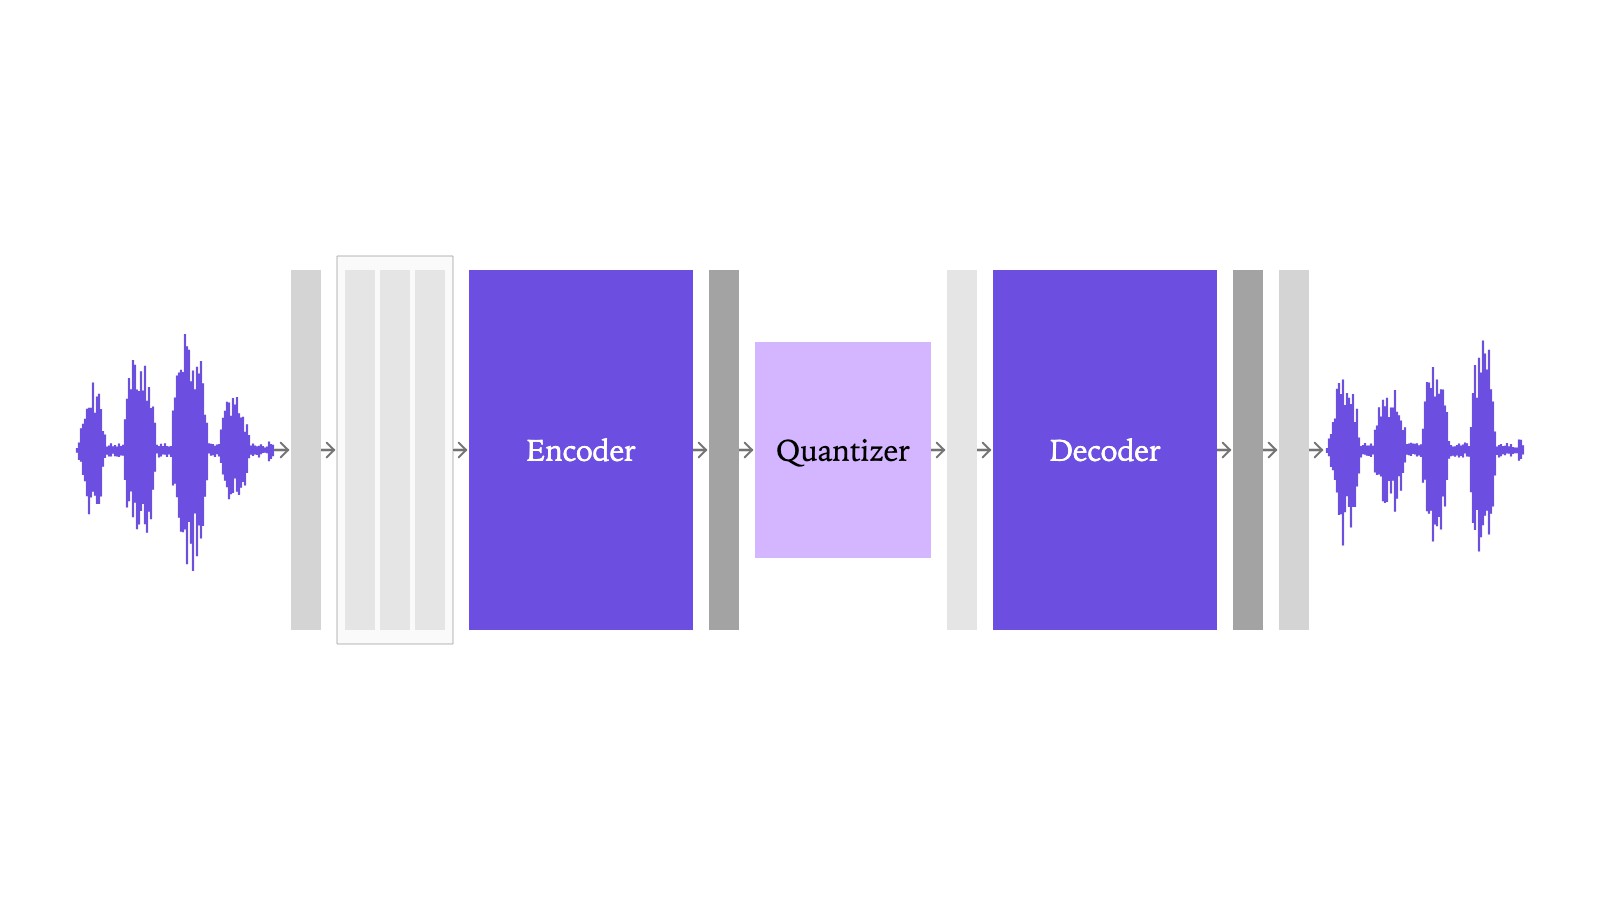
LiquidCodec interviene su un componente piccolo ma decisivo dei modelli vocali: trasformare il suono in token e riconvertire in audio i token previsti dal modello. Nel nuovo approfondimento tecnico, Liquid AI descrive un codec da circa 74 milioni di parametri progettato per il parlato in streaming e l'esecuzione locale efficiente. Il punto è il lavoro che circonda il modello linguistico, dove possono accumularsi ritardi anche quando il modello è compatto.
Il codec è già alla base di LFM3-Audio-2B e LFM3-Omni-2B. La pubblicazione ne spiega struttura e valutazione: non è l'annuncio di un nuovo assistente vocale completo.
Una rappresentazione compatta deve anche essere prevedibile
Un test di ricostruzione parte da una registrazione, la codifica e poi la decodifica. Si confronta quindi il risultato con l'originale. Un sistema che genera parlato affronta un compito diverso: il modello linguistico deve prevedere token audio adatti partendo dal testo o dal contesto, senza codificare prima la registrazione esatta che vuole produrre.
Gli obiettivi diventano due. La rappresentazione deve conservare fedelmente il parlato, ma anche essere relativamente semplice da prevedere per un altro modello. Migliorare il primo aspetto non garantisce il secondo. Un codec può ricostruire bene il proprio input e offrire comunque al generatore una sequenza difficile da imparare.
Liquid AI usa la quantizzazione scalare finita a gruppi. Semplificando, divide le caratteristiche in gruppi e ne arrotonda i valori a scelte discrete. L'azienda la contrappone a un procedimento residuo, nel quale ogni codebook descrive l'errore lasciato dai precedenti. Ridurre quella dipendenza sequenziale consente di prevedere più gruppi in parallelo; non significa eliminare tutte le dipendenze o i ritardi dell'intera conversazione.
Frame da 80 millisecondi, non risposte garantite in 80 millisecondi
La scheda del modello indica parlato mono a 24 kHz, 12,5 frame al secondo e 12 token per frame, per circa 1,65 kbps. Ogni frame rappresenta dunque 80 millisecondi di audio. È un'unità della rappresentazione, non una misura del tempo complessivo necessario a rispondere.
Un'applicazione deve ancora acquisire l'input, stabilire quando intervenire, eseguire gli altri modelli, generare token e riprodurre l'audio. Se utilizza servizi remoti, si aggiunge la rete. Il codec più veloce riduce un tratto del percorso, senza definire da solo la latenza di ogni applicazione costruita intorno a esso.
Liquid AI dichiara una codifica pari a circa 361 volte il tempo reale e una decodifica pari a circa 87 volte, usando FP32 su un solo thread CPU di un MacBook Pro con Apple M4 Max. Sono misurazioni dello sviluppatore in quella configurazione. Il secondo valore indica quanto velocemente il codec elabora l'audio rispetto alla riproduzione; non significa che un assistente risponda alle domande 87 volte più rapidamente.
Un confronto che prova a isolare il contributo del codec
Per l'esperimento di sintesi vocale, Liquid AI dichiara di aver mantenuto uguali dati di addestramento, architettura e budget computazionale, cambiando la rappresentazione audio. Ha utilizzato 101.000 ore in sei lingue e tre seed di generazione nella valutazione. L'obiettivo è distinguere l'effetto del codec da quello di assistenti completi costruiti in modi differenti.
L'azienda riporta il miglior punteggio di naturalezza in tutti gli otto insiemi di test, ma il miglior risultato sugli errori di parole o caratteri soltanto in quattro. La differenza è significativa: naturalezza e intelligibilità non sono la stessa misura. I risultati non autorizzano a dire che LiquidCodec vinca ogni prova, né sostituiscono ascolti indipendenti su accenti e dispositivi diversi.
Per l'italiano serve una cautela specifica: gli insiemi di valutazione elencati nella pubblicazione non comprendono una prova dedicata alla nostra lingua. Le 107 lingue dichiarate per la prima fase di addestramento non dimostrano da sole una qualità equivalente in italiano.
La scheda limita inoltre la valutazione al parlato: musica, canto e suoni ambientali non sono stati valutati. Distingue il repository BF16 autonomo dai decoder quantizzati inclusi nei pacchetti GGUF di LFM3 Audio e Omni, senza presentarli come download separati del solo codec.
Per chi segue i sistemi di IA locale, il punto concreto è che la dimensione del modello non determina da sola una buona esperienza vocale. Anche il formato con cui i componenti si scambiano informazioni può facilitarne o complicarne il lavoro. LiquidCodec prova a migliorare quel passaggio, pubblicando condizioni sufficienti a capire dove termina la promessa di velocità.