Una preferenza condivisa per l’addestramento IA arriva in robots.txt, ma i dettagli cambiano
Google e Microsoft descrivono l’adozione di un segnale comune proposto, distinguendo scansione, addestramento e grounding.
Per chi gestisce un sito arriva una proposta di segnale condiviso con cui esprimere il rifiuto dell’uso dei contenuti per addestrare modelli generativi, mantenendo separati i controlli sulla normale scansione dei motori di ricerca. Il vantaggio pratico è avere una preferenza riconoscibile invece di dover inseguire un elenco crescente di nomi specifici delle aziende.
Non è ancora uno standard di internet e non costituisce una barriera tecnica alla copia. La sua utilità dipende dai fornitori che riconoscono il segnale e applicano le regole dichiarate. Google e Microsoft hanno illustrato piani di implementazione con differenze importanti nei tempi e nel perimetro.
Un segnale comune per un uso preciso
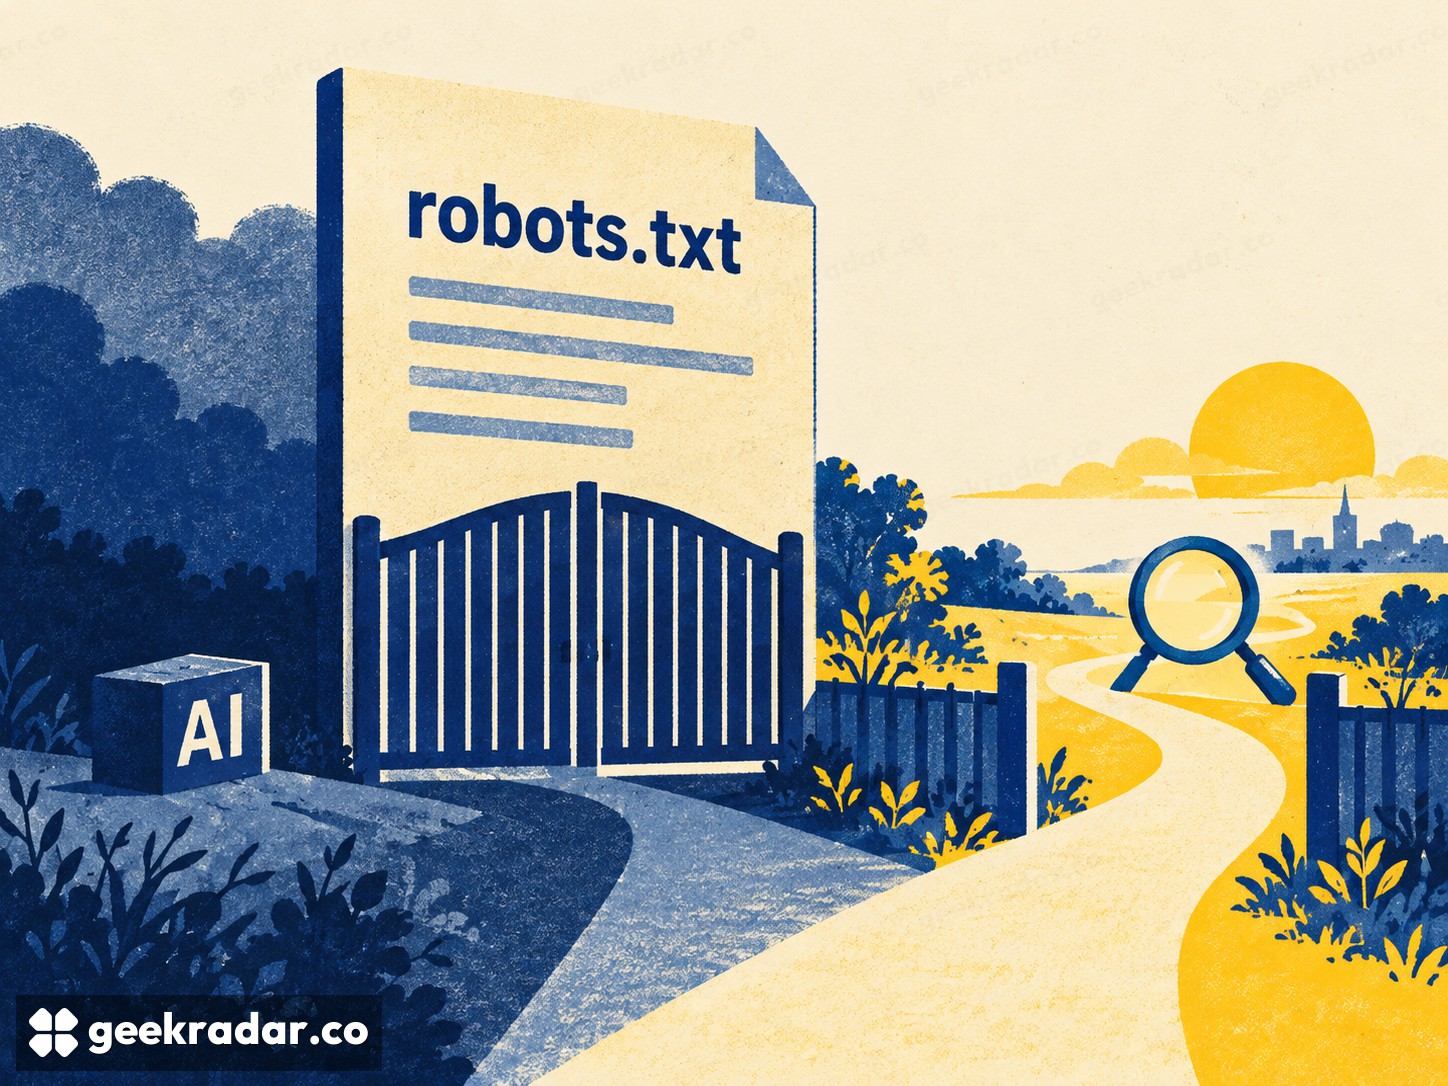
L’Internet-Draft pubblicato il 30 ottobre definisce il token __usage_ai-training. Il gestore può inserirlo in un gruppo User-Agent del file robots.txt e utilizzare le consuete regole Allow e Disallow per i percorsi. La preferenza può così riguardare tutto il sito o soltanto determinate sezioni.
La proposta separa l’uso del contenuto dal permesso concesso a un crawler di recuperarlo. Un editore potrebbe volere un articolo nei risultati di ricerca senza accettarne l’impiego per modificare i parametri di un modello generativo. Bloccare ogni accesso sarebbe una decisione più ampia, potenzialmente incompatibile con la visibilità desiderata.
Il documento è una bozza individuale. Essere presente nel sistema IETF non significa aver ricevuto l’approvazione dell’organizzazione. La proposta distingue inoltre il nuovo token dalle regole dei crawler esistenti e permette ai fornitori di precisare quando prevalgano istruzioni più specifiche.
Google mantiene il ruolo di Google-Extended
Nell’annuncio di Google, il supporto è previsto nel 2027. La preferenza condivisa interagirà con Google-Extended, senza sostituire automaticamente tutte le decisioni già espresse dai siti. Una configurazione esplicita di Google-Extended resta quindi rilevante come indicazione più specifica.
È un dettaglio importante per la migrazione. Aggiungere una regola comune non dimostra che una vecchia istruzione dedicata a una singola azienda abbia smesso di produrre effetti. Occorre confrontare il comportamento risultante con la scelta desiderata, soprattutto quando addestramento e utilizzo del contenuto a supporto delle risposte devono seguire criteri diversi.
La transizione Microsoft ha più scadenze
Microsoft introduce controlli distinti per addestramento e grounding. Secondo l’azienda, non cambiano l’idoneità alla normale ricerca Bing, che resta soggetta ai consueti requisiti di scansione e indicizzazione.
L’applicazione delle nuove preferenze dovrebbe iniziare il 1° febbraio 2027, man mano che le pagine vengono visitate nuovamente. Il precedente trattamento di NoArchive e NoCache per questi scopi terminerà il 1° marzo. Dal 15 dicembre è previsto uno strumento di transizione in Bing Webmaster Tools per i siti idonei che utilizzano già i segnali precedenti.
Anche il grounding presenta una distinzione significativa: l’opzione DisallowExtended permette gli impieghi nelle esperienze IA di Microsoft, ma limita i prodotti di grounding destinati a terzi descritti nell’annuncio. Non equivale a vietare qualsiasi utilizzo nell’IA. Inoltre, controlli sulla singola pagina e preferenze di addestramento a livello di sito hanno ambiti differenti.
Per editori e gestori di siti italiani sono quindi scadenze operative, non soltanto una dichiarazione di principio. Una preferenza deve essere pubblicata, riconosciuta e incontrata durante una nuova scansione. Gli strumenti temporanei di Microsoft coprono parte della transizione; non sostituiscono indefinitamente la configurazione delle pagine.
Il token comune potrebbe ridurre il lavoro necessario per comunicare la stessa scelta a più fornitori. Non stabilisce compensi, non cancella l’addestramento passato e non obbliga tecnicamente un crawler che ignora le istruzioni. Il suo valore sarà più concreto: far sì che la decisione dell’editore arrivi intatta dal file di configurazione all’uso effettivo dei contenuti.