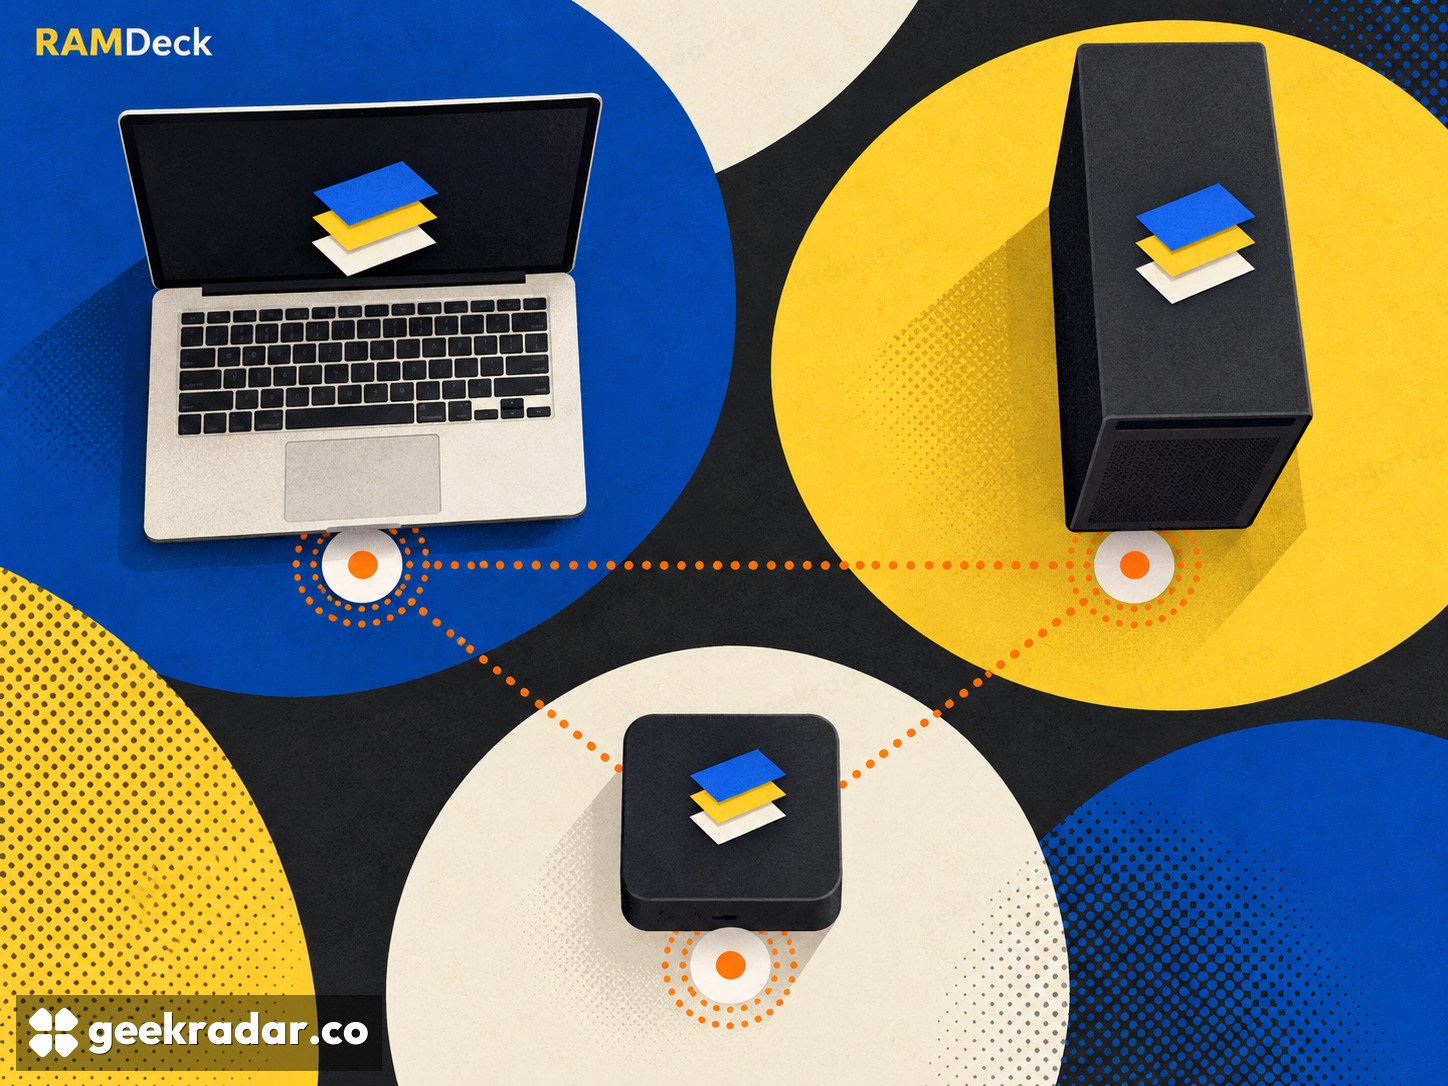
RAMDeck distribuisce un modello tra computer, ma non crea un’unica RAM veloce
Distribuire i livelli può rendere eseguibile un modello. Latenza, dispositivi diversi e benchmark scelti determinano quanto il risultato sia utile.
La promessa di RAMDeck è allettante per chi conserva vecchi computer: usarne diversi per eseguire un modello di IA locale troppo grande per una sola macchina. Il progetto sta attirando attenzione con un hub proposto a 109 dollari, ma le informazioni più rivelatrici arrivano dalla documentazione software e dai benchmark degli sviluppatori. Aggiungere un dispositivo può aumentare la capacità disponibile e, contemporaneamente, rallentare la generazione.
La spiegazione del progetto descrive la distribuzione del lavoro sulla rete locale. Conta anche il repository pubblico: non basta una scatola a trasformare memorie separate in un unico banco di RAM convenzionale. È il software ad assegnare le parti del modello e coordinare il calcolo.
I pesi restano sui dispositivi, i risultati intermedi viaggiano
Distribuendo i livelli del modello, ciascuna macchina conserva i pesi assegnati ed esegue la propria parte del lavoro. Le attivazioni intermedie passano al partecipante successivo. Non è necessario ricopiare tutto il modello sulla rete per ogni token generato.
Non equivale però neppure a installare altra RAM nello stesso computer. Il processore remoto deve effettuare i calcoli e la rete introduce attese. Una macchina veloce può rimanere in attesa di una più lenta. La capacità complessiva risponde quindi alla domanda «ci sta?», senza risolvere automaticamente «sarà abbastanza reattivo?».
Le FAQ di RAMDeck consigliano la rete cablata e descrivono il contributo delle diverse piattaforme. Precisano anche la licenza: il codice è definito source-available, con un'aggiunta Commons Clause, non open source senza restrizioni. Poter leggere ed eseguire il codice non significa poterlo ridistribuire commercialmente in qualsiasi forma.
I benchmark mostrano il compromesso
La tabella pubblicata dagli sviluppatori comprende un modello denso da 27 miliardi di parametri a 1,92 token al secondo su quattro dispositivi. Un'altra prova usa Qwen3-Coder, modello mixture-of-experts da circa 17GB, su un sistema con RTX 3060 e un Mac mini M4, dichiarando circa 39 token al secondo. Sono misure del progetto, non test di GeekRadar, e non costituiscono un confronto controllato fra dimensioni dei modelli.
Un modello denso impiega tutti i suoi parametri nel calcolo di ciascun token. Un mixture-of-experts seleziona un sottoinsieme di esperti: il numero totale dei parametri non descrive allo stesso modo il lavoro attivo. Cambiano inoltre hardware, quantizzazione, contesto e distribuzione. Concludere che «30B è più veloce di 27B» ignorerebbe quasi tutte le ragioni del risultato.
La stessa tabella riporta il rallentamento di un modello più piccolo dopo l'aggiunta di un telefono via Wi-Fi. È un controesempio utile all'idea che ogni dispositivo aggiuntivo sia un miglioramento. Il contributo deve compensare i costi di comunicazione e calcolo: la RAM presente da qualche parte sulla rete non diventa automaticamente memoria veloce per quel lavoro.
L'hub deve giustificare la propria comodità
La proposta in crowdfunding va distinta dalla capacità software di distribuire l'inferenza. Un prodotto finito potrebbe semplificare connessioni e amministrazione; la campagna non ne prova però consegna e prestazioni sul particolare insieme di macchine dell'acquirente. I 109 dollari annunciati non sono un prezzo finale italiano comprensivo di spedizione e imposte.
Per sperimentare, il punto di partenza sensato è il software disponibile con un modello dai requisiti noti. Chi cerca velocità interattiva affidabile dovrebbe prima confrontare questa soluzione con una singola macchina adeguata. La promessa più solida di RAMDeck è rendere accessibili modelli che altrimenti non entrerebbero in memoria. Migliorare la conversazione richiede molto più che sommare i gigabyte sulle etichette.


